세션 개요
무엇을 만들고 싶은가 → 어떤 벽이 있는가 → 어떻게 넘었는가
일곱 개의 허들을 같은 3단 구조로 반복해서 넘어갑니다.
UE 5.6 포크에서 엔진을 직접 손봐 애니풍 카툰 룩을 만든 과정을 공개한 세션입니다. 결과물 자랑이 아니라 순정 엔진이 어디서 막는지, 그 벽을 어떤 대가를 치르고 넘었는지를 순서대로 보여주는 구성이라, 카툰 렌더링에 관심이 없어도 엔진을 개조해야 하는 사람에게 그대로 쓸 수 있는 지도가 됩니다.
발표자가 남긴 당부
시간 관계상 커스터마이징 코드는 상당 부분 의사 코드로 생략됐습니다. 중요한 키워드는 메모해두고 나중에 엔진 코드에서 직접 검색해보라는 것이 발표자의 권장 사항이었고, 이 문서에서도 등장하는 파일·함수 이름은 가능한 한 실제 엔진의 표기 그대로 적었습니다.
배경
왜 지금 카툰 렌더링인가
애니풍 카툰 룩을 전면에 내세운 타이틀이 계속 늘고 있습니다. 발표에서는 출시 순서대로 원신 → 붕괴: 스타레일 → 젠레스 존 제로를 예로 들었습니다. 그런데 막상 이런 룩을 언리얼에서 만들려고 하면 현장에서 막히는 지점이 여럿 나옵니다. 이 니즈를 하나씩 분석하며 엔진을 커스터마이징했고, 그 과정에서 스타일라이즈드 작업이 활발한 유니티 쪽을 많이 참고해 어떤 구조적 차이가 있는지 짚었습니다.
 원신
 붕괴: 스타레일
 젠레스 존 제로
UE 5.8의 Substrate Toon이 아니라 커스터마이징을 택한 이유
발표 시점 기준으로 엔진에는 이미 공식 툰 셰이딩이 들어와 있었습니다. 그럼에도 자체 커스터마이징을 계속한 이유는 두 가지였습니다.
| # | 이유 |
|---|---|
| 1 | 자유도. 공식 기능은 주로 프로파일이나 램프 텍스처를 튜닝하는 방식이지만, 이 프로젝트는 머티리얼 그래프 편집으로 스페큘러나 그림자 처리까지 아티스트가 직접 다룰 수 있게 열어두는 것을 목표로 했습니다. |
| 2 | 과정 자체의 공유. 순정 엔진의 특성을 살펴보고 제약을 이렇게 넘어갔다는 과정을 공유하는 것. 카툰 렌더링이 아니더라도 엔진 튜닝에 관심 있는 사람에게 가이드가 되기를 바란다고 했습니다. |
경쟁이 아니라 서로 다른 목적을 보완하는 프로젝트로 봐주시면 좋겠습니다.
데모 결과물
시험용 데모의 셰이딩 모델 이름은 Stylized Anime[1], 캐릭터는 VRoid에서 제공하는 아바타 샘플 중 하나였습니다. 이 데모가 보여준 것은 “툰 룩처럼 보인다”가 아니라 툰 룩이 엔진의 라이팅 파이프라인 안에서 제대로 살아있다는 점입니다.
- 모든 종류의 직접광 효과를 받습니다.
- 자기 그림자만 그리는 게 아니라 다른 물체가 드리운 그림자도 받습니다.
- 환경광에 영향을 주고받습니다.
지도
일곱 개의 허들과 핵심 해법
| # | 요구 | 핵심 해법 |
|---|---|---|
| 1 | 라이팅을 직접 짜고 싶다 | 커스텀 셰이딩 모델 / BxDF 수정 |
| 2 | 머티리얼 그래프에서 디렉셔널 라이트를 받고 싶다 | 전용 노드 + HLSL 컴파일 순서 제어 |
| 3 | 베이스 패스에서 그림자도 받고 싶다 | VSM 파이프라인 순서 + GBuffer 검사 스킵 |
| 4 | 셀프 섀도우를 제어하고 싶다 | 4개 섀도우 그룹 + Nanite 비트 플래그 |
| 5 | 메인 라이트 외 광원도 다루고 싶다 | 라이트 커브(Light Curve) |
| 6 | 구역별로 다르게 적용하고 싶다 | 포스트 프로세스 볼륨 |
| 7 | 셰이더의 커스텀 데이터를 남기고 싶다 | GBuffer 통로 설계 |
허들 1과 2의 관계가 이 세션 전체의 설계 철학입니다 — “직접 구현”에서 “아티스트에게 자원을 열어주기”로의 전환.
허들 1
나만의 라이팅을 직접 짜고 싶다
정공법은 커스텀 셰이딩 모델. 문제는 건드릴 곳이 너무 많다는 것.
기초 다지기
BxDF가 뭐고, 왜 거기를 고쳐야 하는가
BxDF는 “빛이 L 방향에서 들어오고 카메라가 V 방향에 있을 때, 이 표면에서 빛이 얼마나 나가는가”에 답하는 함수입니다. 디퍼드 렌더러에서 베이스 패스는 직접광을 계산하지 않고 주로 GBuffer를 채웁니다(이미션이나 미리 구운 간접광 같은 일부 항은 여기서 더합니다). 직접광 라이팅은 나중에 라이트 패스가 화면을 훑으면서 GBuffer를 해석하고, 셰이딩 모델별 평가 함수를 부르는 순간에 일어납니다. 엔진 코드에는 이 호출이 그대로 있습니다 — FDirectLighting Lighting = EvaluateBxDF( GBuffer, N, V, L, NoL, Shadow );
물리 기반 엔진은 이 함수를 두 개의 표준 블록으로 조립합니다. 디퓨즈 로브(램버트 계열: 색 × N·L)와 스페큘러 로브(GGX 계열 마이크로패싯)입니다. 툰 셰이딩은 이 매끈한 두 로브를 스타일라이즈된 것으로 갈아끼우는 작업이라, 포스트 필터가 아니라 셰이딩 모델이 분기되는 바로 그 자리에 들어가야 합니다. 그래서 첫 허들이 “엔진 셰이더 코드를 고친다”가 되는 겁니다.
정공법 — 셰이딩 모델 하나를 엔진에 제대로 장착하기
셰이딩 코드를 직접 고치는 방식입니다. 다만 셰이딩 모델 하나를 온전히 붙이려면 건드려야 할 곳이 매우 많습니다.
- 열거형 식별자 등록.
EMaterialShadingModel에 값을 추가합니다 (MSM_DefaultLit,MSM_ClearCoat등이 있는 그 열거형). - 셰이더 템플릿과
ShadingCommon.ush. 공통 매크로·상수·디버그 색상을 설정합니다. 여기 붙는SHADINGMODELID_*상수는 8비트 채널의 하위 4비트만 쓰도록 정해져 있습니다 — 상위 4비트는 출력 스킵 플래그가 이미 쓰고 있습니다. ShadingModels.ush에 라이팅 정의(BxDF)를 넣습니다. 위에서 본EvaluateBxDF가 사는 곳입니다.- 파라미터가 늘었다면 GBuffer 패킹/언패킹. 베이스 패스 픽셀 셰이더가
EncodeGBuffer로 쓰고DecodeGBufferData로 다시 읽습니다. - 라이트 패스마다 그 값을 읽어 처리. Deferred / Clustered Deferred / Forward / Mobile이 각각 별도의 셰이더 경로입니다.
정공법이긴 하지만 이 모든 곳을 다 건드려야 합니다. 그리고 이건 에픽이 공식 문서로 안내하는 절차가 아니라, 엔진을 개조하는 사람들이 경험으로 쌓아온 체크리스트입니다.
기초 다지기
계단식 음영은 램프 텍스처 한 장에서 나온다
램프는 N·L을 인덱스로 삼아 읽는 작은 1D 룩업 텍스처입니다. 내용은 아티스트가 칠한, 계단이 있는 그라데이션입니다. brightness = N·L 대신 brightness = Ramp[N·L]로 바꾸면, 한 계단 구간 안의 모든 N·L 값이 같은 밝기 하나로 뭉개집니다. 구(球) 표면을 매끄럽게 돌던 명암 경계가 뚝 떨어지는 띠로 바뀌는 게 이 때문입니다.
중요한 건 입력이 계단 경계를 넘을 때만 결과가 움직인다는 점입니다. 그래서 띠가 실제 광원 방향과 실제 그림자 마스크를 따라 움직입니다. 화면을 후처리로 양자화하는 방식과 근본적으로 다른 지점입니다. 참고로 UE 5.8 공식 툰 셰이딩도 정확히 이 설계를 택했습니다 — 릴리스 노트 표현이 “ramp-based diffuse and specular control with dithering”입니다.
한계 — 이것이 다음 허들의 동기
- 코딩이 익숙하지 않은 아티스트에게 너무 어렵습니다. 라이팅을 살짝 바꾸는 일조차 결국 엔진 코드를 건드리는 작업이 됩니다.
- 반복 주기가 너무 깁니다.
아티스트 시안 → 프로그래머 코드 수정 → 빌드 → 셰이더 컴파일 → PIE 확인 → 다시 아티스트
이걸 머티리얼 그래프 노드로 만들어주면 이 주기가 통째로 사라집니다. 아티스트가 그래프에서 바로 바꾸고 바로 결과를 봅니다. 허들 2부터 끝까지, 발표의 방향은 전부 이 문장에서 나옵니다.
허들 2
머티리얼 그래프에서 디렉셔널 라이트를 받고 싶다
엔진이 일부러 막아둔 문을, 컴파일 순서를 바꿔서 연 사례.
유니티와의 구조적 차이
| 유니티 | 언리얼 | |
|---|---|---|
| 기본 노드만으로 | 제한적 | 제한적 |
| 엔진 HLSL 함수 접근 | 비교적 간단 → 커스텀 노드 제작이 쉽다 | 막혀 있다 (의도된 설계) |
언리얼에도 기존 대안은 있습니다. MPC(Material Parameter Collection)로 필요한 라이팅 정보를 만들어 넘기는 방법입니다. 하지만 매번 C++에서 라이트 정보를 수동으로 채워야 하고, 그림자 같은 항목은 훨씬 까다롭습니다. 되긴 되지만 아티스트에게 쉽지 않다는 게 문제였습니다.
왜 디렉셔널 라이트만 여는가
| # | 로컬 라이트를 노드로 만들기 어려운 이유 |
|---|---|
| 1 | 개수가 플랫폼과 셰이딩 방식에 따라 달라 불분명하고, 머티리얼 그래프에는 for문이 없어 “n개 라이트를 순회한다”는 표현 자체가 노드로 만들어지지 않습니다. |
| 2 | 라이트 타입마다 필요한 정보가 다릅니다. 특히 Rect Light는 하나의 인터페이스로 묶기 까다롭습니다. |
| 3 | Rect Light는 정보를 넘겨받더라도 그 뒤의 라이팅 계산이 기본적으로 복잡해서, 이를 아티스트에게 맡기는 것은 좋은 선택이 아니어 보였습니다. |
반면 메인 라이트는 단 하나라 노드로 깔끔히 받을 수 있고, 스타일라이즈 표현에서 비중도 가장 큽니다. 그래서 디렉셔널 라이트부터 노드로 열고, 다른 라이트들은 커브 에셋으로 다룹니다(허들 5).
기초 다지기
머티리얼 그래프는 어떻게 HLSL이 되는가
에픽 공식 자료에 따르면, 생성되는 HLSL은 Engine/Shaders/Private/MaterialTemplate.ush를 바탕으로 만들어집니다. 이 파일에는 본문이 %s 자리표시자로 비어 있는 구조체와 함수들이 들어 있고, FHLSLMaterialTranslator가 그 자리를 채웁니다. 그리고 그래프의 대부분은 CalcPixelMaterialInputs 함수 안으로 들어갑니다— 계산을 그래프 여러 곳에서 재사용할 수 있게 하려는 구조입니다.
그래프에서 디렉셔널 라이트 정보를 쓴다는 건, 결국 CalcPixelMaterialInputs 안에서 엔진 함수를 호출할 수 있어야 한다는 뜻입니다. 여기서 벽에 부딪힙니다. HLSL은 위에서 아래로 컴파일되므로, 내 위치보다 아래에 선언된 함수는 호출할 수 없습니다. 발표자는 엔진의 정의 순서가 이렇게 잡혀 있는 것이 머티리얼이 엔진 내부 함수에 함부로 접근하지 못하게 막아둔 의도된 설계라고 해석했습니다.
해법 — 인클루드 대상에 태그를 달아 컴파일 순서를 제어
엔진 함수 선언이 먼저 처리되고, 그걸 쓰는 부분은 뒤로 밀려서 컴파일되도록 코드를 나눠주는 태그를 부여했습니다. 태그를 달아준 대상이 Material.ush이고, BasePassPixelShader.usf에서 이 파일을 두 번 인클루드합니다.
① Pre-stage 태그와 함께 include  →  원래 아래에 있던 엔진 함수들이 먼저 정의됨
   (중간에 다른 인클루드들이 여럿 들어옴 — 이들도 Pre-stage 태그를 붙여 정의 순서 보장)
② Post-stage로 다시 include      →  머티리얼 본체가 정의되며 그 함수들을 실제로 사용
전용 노드 만들기 — 3파트
핵심은 UMaterialExpression을 상속받아 셰이더 코드를 만들어내는 전용 노드를 등록하는 것입니다. 에디터 모듈에서 클래스를 만들고, 노드 이름을 정하는 GetCaption과 셰이더 코드를 생성하는 Compile을 구현합니다. 둘 다 UMaterialExpression의 가상 함수로, Compile은 “새 셰이더 코드 청크를 만든다”, GetCaption은 “머티리얼 에디터에 표시할 텍스트를 반환한다”가 공식 설명입니다.
파트 1 — 등록
- 클래스
UMaterialExpressionMainLight- 상속
UCLASS매크로와 함께UMaterialExpression을 상속하면 머티리얼 그래프에 노출됩니다- 출력 핀
- 생성자에서 3개 등록 — Direction(0), Color(1), Shadow(2)[2]
- 이름
GetCaption으로 “Main Light” 부여
파트 2 — Compile
어떤 HLSL을 만들어낼지 결정
먼저 이 노드를 쓸 수 없는 환경인지 검증합니다 — Stylized Anime이 켜져 있는지, Substrate가 아닌지, 해당 셰이딩 모델을 쓰고 있는지, WPO 같은 버텍스 스테이지에 물린 건 아닌지. 하나라도 어긋나면 에러를 내며 머티리얼 에디터에 뭐가 잘못됐는지 알려주면서 막아줍니다. 통과하면 출력 인덱스로 분기해 대응하는 엔진 함수를 호출합니다.
파트 3 — 코드 생성
실제 HLSL 텍스트를 뱉는 지점
HLSLMaterialTranslator의 AddCodeChunk를 호출합니다. 이 함수가 불리면 셰이더에 호출 한 줄이 들어갑니다. 호출되는 HLSL 함수의 정의는 MaterialTemplate.ush 안에 있고, 내용 자체는 엔진이 원래 디렉셔널 라이트 정보를 가져오는 코드를 발췌해 그대로 붙여 넣은 것입니다.
| AddCodeChunk 인자 | 내용 |
|---|---|
| 1번째 | 반환 값을 받을 변수의 타입 (예: float3) |
| 2번째 | 셰이더에 들어갈 실제 HLSL 텍스트 (printf 형식) |
호출 쪽 반환 타입에 맞춰 정의를 작성하고, 이걸 Pre-stage 스코프로 묶으면 앞서 본 것처럼 먼저 선언되도록 만들 수 있습니다.
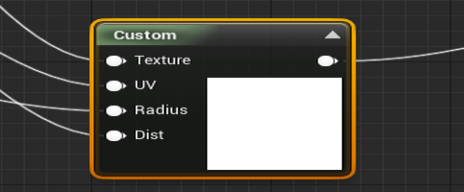
C++ 개발자가 하는 역할은 아티스트가 자유롭게 활용할 수 있도록 “자원(노드)”을 열어주는 것에 가깝습니다.
더 깊이
이 API 자체가 지금 갈아엎히는 중입니다
AddCodeChunk 계열은 컴파일러/트랜슬레이터의 protected 멤버라, 프로젝트 쪽 코드만으로는 호출할 수 없습니다 — 이 지점에서 엔진 포크가 사실상 강제됩니다. 게다가 에픽은 레거시 머티리얼 트랜슬레이터가 전면 개편 중이며 폐기 경로에 있다고 공지했고, 실제로 UE 5.8의 공식 툰 노드는 기존 Compile과 함께 새 경로인 Build(MIR::FEmitter&)를 같이 구현합니다. 지금 이 방식을 그대로 따라갈 사람은 중장기 유지보수 비용을 계산에 넣어야 합니다.
보너스 — 커스텀 노드에서 엔진 셰이더 함수 호출하기 (최종 제외됨)
컴파일 순서를 바꾸는 방법을 응용하면 커스텀 노드에서도 엔진 셰이더 함수를 호출할 수 있습니다. 원래 커스텀 노드는 HLSL 정의 순서상 강제로 앞단에 등록되어 미룰 수 없는데, 그 부분만 Post-stage로 넘기면 됩니다. 이렇게 하면 HLSL에서 for문으로 로컬 라이트를 도는 루프까지 만들 수 있습니다.
그런데 최종적으로 이 기능은 뺐습니다
커스텀 노드를 WPO에 붙이면 버텍스 셰이더 경로로 컴파일되는데, 이때는 접근 가능한 엔진 함수가 달라져 컴파일 에러가 납니다. 특히 엔진 기본 기능인 SpeedTree에서 이런 충돌이 있었습니다. 간단히 WPO 사용을 제한할 수도 있었지만, “아티스트 편의성을 준다”는 목적을 해치는 듯하여 제외했다고 합니다.
허들 3
베이스 패스에서 그림자도 받고 싶다
Direction·Color는 코드를 복사해 붙이면 됐지만, 그림자는 “아직 존재하지 않는” 데이터였습니다.
허들 2에서 Direction과 Color는 엔진 HLSL 코드를 찾아 그대로 복사해 붙이는 것으로 해결됐습니다. 그림자도 같은 방법이면 될 것 같지만 충분하지 않습니다. 머티리얼 그래프로 만든 이 함수는 일반적인 베이스 패스에서만 호출되는 게 아니라 Lumen Card Capture Pass 같은 다른 패스에서도 호출되기 때문입니다.
기초 다지기
왜 Lumen이 내 머티리얼 함수를 부르는가
Lumen은 메시마다 여러 각도에서 머티리얼 속성을 캡처해 서피스 캐시로 보관합니다. 이 캡처 지점을 Card라고 부릅니다. 공식 문서가 “Pixel Depth, Camera Position, Camera Vector처럼 시점에 의존하는 노드를 쓴 머티리얼은 Lumen Surface Cache 뷰 모드에서 잘못 보일 수 있다”고 경고하는 게 그 증거입니다 — 그래프가 캡처 시점에 실제로 실행되지 않으면 애초에 잘못 보일 일이 없습니다.
즉 그림자 정보를 요구하는 함수가 렌더 경로마다, 플랫폼마다 다른 시점에 불릴 수 있고, 정작 호출 시점에는 그림자가 아직 준비되지 않은 상황이 생깁니다. 그래서그림자가 준비되는 시점 자체를 손대야 했습니다.
| 렌더 경로 | 상황 | 해법 |
|---|---|---|
| Forward / Mobile | 몇 가지 조건 필요 | Shadow Mask 패스를 강제 설정하면 머티리얼 그래프에서 그림자 취득 가능. 이쪽 경로엔 Lumen이 없으므로 여기까지만 고려해도 충분 |
| Deferred + CSM | 비교적 가볍게 풀림 | 섀도우 맵을 베이스 패스 이전에 준비하도록 강제[3] |
| Deferred + VSM | 베이스 패스 이후에 그려져서 읽을 수 없음 | 이번 사례에서 실제로 손댄 핵심 |
기초 다지기
Virtual Shadow Maps가 뭘 하는 물건인가
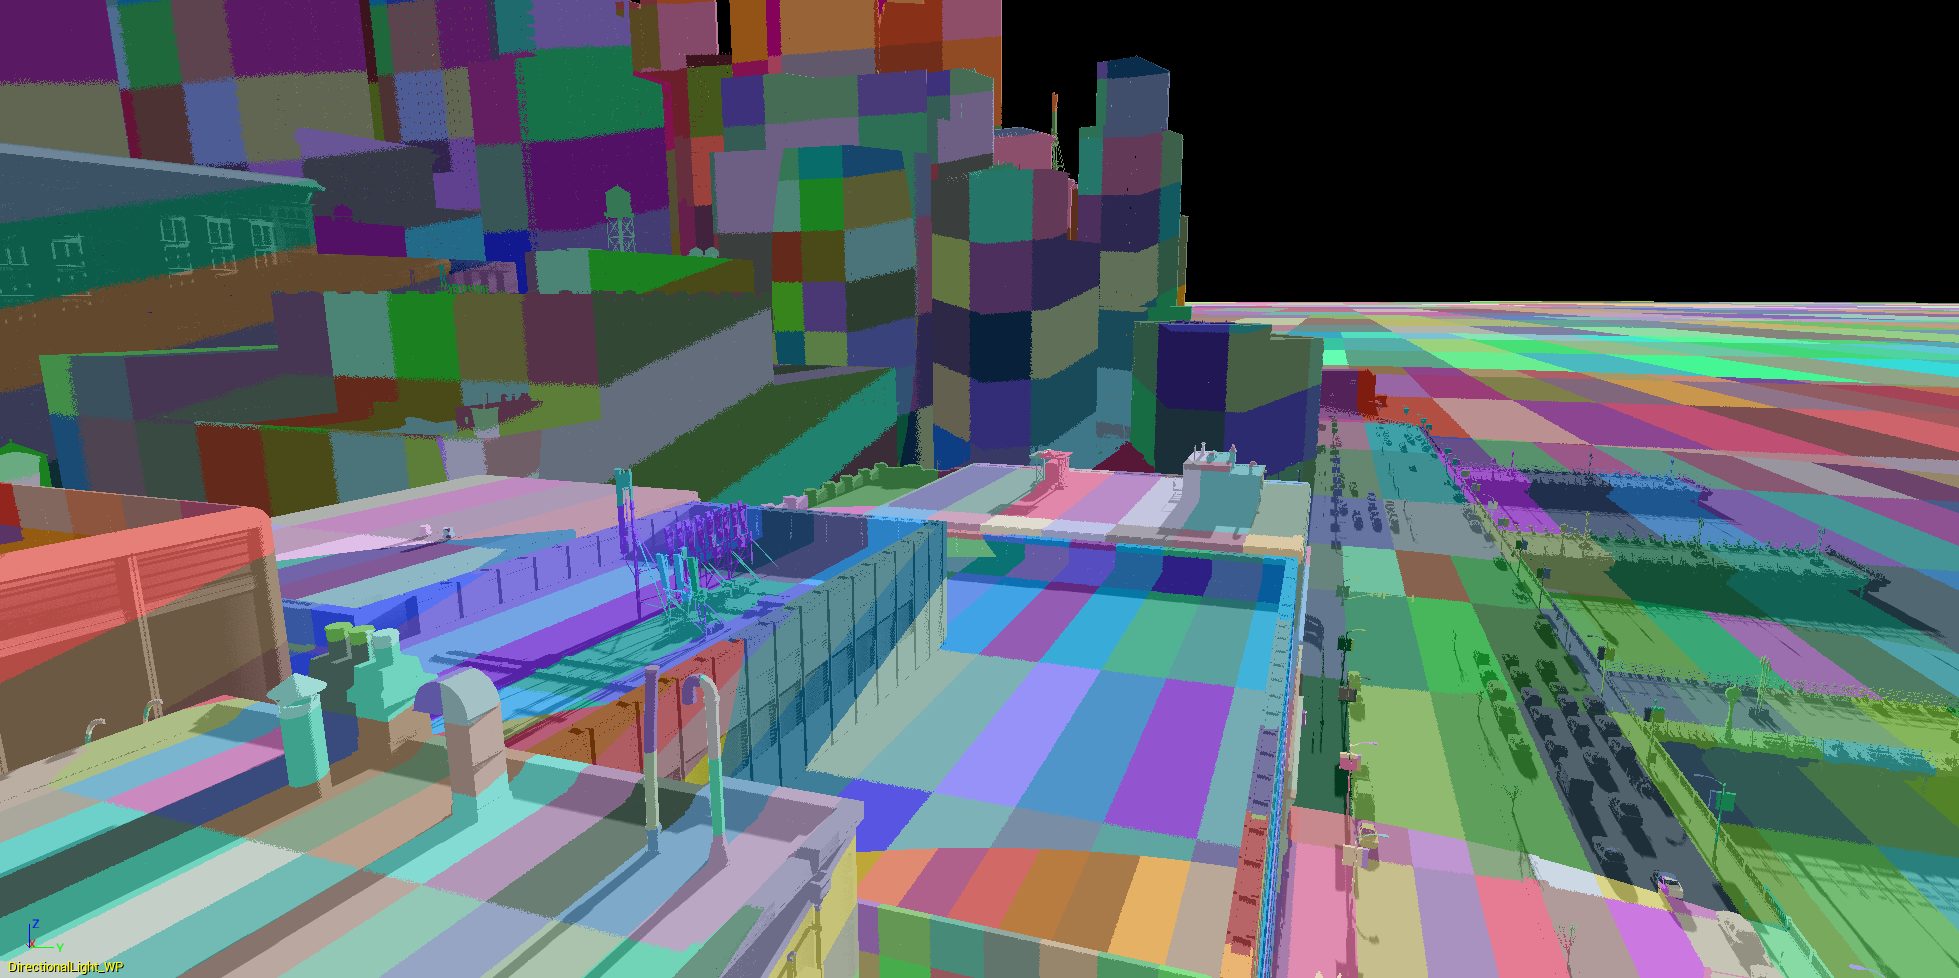
공식 문서 기준으로 VSM은 가상 해상도 16k × 16k의 섀도우 맵입니다. 라이트 하나에 그만한 텍스처를 매 프레임 실제로 그리는 건 불가능하고, 대부분 낭비이기도 합니다 — 화면에 보이는 픽셀을 셰이딩하는 데 쓰이는 텍셀만 의미가 있으니까요.
그래서 VSM은 가상 해상도는 유지하되 물리적으로는 128 × 128 텍셀 페이지 단위로 쪼개서, 필요한 페이지만 할당해 그립니다. 문서 표현이 정확히 이렇습니다 — “Pages are allocated and rendered only as needed to shade on-screen pixels based on an analysis of the depth buffer.” 페이지 테이블이 가상 텍셀 → 물리 페이지 주소를 중개하고, 무효화되지 않은 페이지는 프레임 간에 캐시됩니다. 디렉셔널 라이트는 여기에 클립맵을 얹어 기본 6~22 레벨(카메라 기준 64cm에서 약 40km까지)을 커버합니다.
사진 · 자료
실제로 할당된 페이지만 보이는 VSM 페이지 시각화
1차 시도 — 순서만 바꿔봤지만 실패
도해
VSM은 베이스 패스보다 뒤에 그려진다
기존 순서
1차 시도 — VSM을 앞으로
순서만 바꿔서는 여전히 그림자를 받을 수 없었습니다. 문제는 더 깊은 곳에 있었습니다.
진짜 원인 — Page Marking 단계가 무엇을 보는가
페이지를 그릴지 말지 먼저 판단하는 단계가 Page Marking입니다. 공식 문서는 이 단계를 “Depth buffer analysis is used as the primary method of marking pages that are needed to render”라고 설명합니다. 즉 깊이 버퍼를 필요로 하므로, 깊이를 만드는 패스보다 앞으로 옮길 수가 없습니다.
발표에서는 이 판단이 GBuffer까지 검사한다고 설명했습니다 — 이 픽셀이 정말 그림자가 필요한 셰이딩 모델인지, 노멀이 라이트를 향하고 있는지를 확인해 불필요한 페이지를 걸러내는 꼼꼼한 컬링이라는 것입니다.[4] 깊이만 본다면 깊이 프리패스 뒤로는 앞당길 여지가 있지만, GBuffer까지 검사하면 마킹이 베이스 패스의 산출물에 의존하므로 순서를 뒤집을 수 없습니다.
해법 — GBuffer 검사를 건너뛰는 플래그
커스텀 불리언 플래그(SkipGBufferTest)를 하나 추가해, 우리 경로에서는 GBuffer 검사를 건너뛰고 바로 페이지를 마킹하도록 했습니다.
| 트레이드오프 | 내용 |
|---|---|
| 비용 | 검사 없이 마킹하므로 필요 없는 페이지도 일부 마킹됩니다 |
| 품질 | 그림자 결과 자체는 정확하게 나옵니다 |
| 완화 | Depth Prepass는 있으므로 Depth 검사는 그대로 남겨둘 수 있어 최소한의 컬링은 유지됩니다 |
여기까지 해서 Shadow 핀까지 연결된 Main Light 노드가 완성됩니다.
허들 4
셀프 섀도우를 끄고, 남의 그림자는 받고 싶다
“팔 그림자가 몸통에 지지 않게” 하려면 그림자를 오브젝트 단위로 분리해야 합니다.
| 케이스 | 내용 |
|---|---|
| A | 한 캐릭터 안에서 팔과 몸통처럼 서로 그림자를 받지 않았으면 하는 경우 |
| B | 캐릭터와 배경은 서로 정상적으로 주고받는 경우 |
| C | 캐릭터와 보스 — 서로의 그림자는 정상적으로 주고받되, 자기 팔과 몸통끼리는 받지 않는 경우 |
그림자가 그려지는 원리 (복습)
| 단계 | 내용 |
|---|---|
| 1단계 | 라이트 시점에서 표면까지의 거리(depth)를 재서 저장합니다 → 이것이 섀도우 맵 |
| 2단계 | 카메라 기준으로 화면을 그리며, 한 픽셀에서 라이트 방향으로의 거리를 섀도우 맵 값과 비교합니다. 저장된 거리가 더 짧으면 사이에 뭔가 가로막고 있다는 뜻이므로 그 픽셀은 그림자 |
사진 · 자료
캐스케이드 섀도우 맵 — 카메라 거리에 따라 섀도우 맵을 나눈다
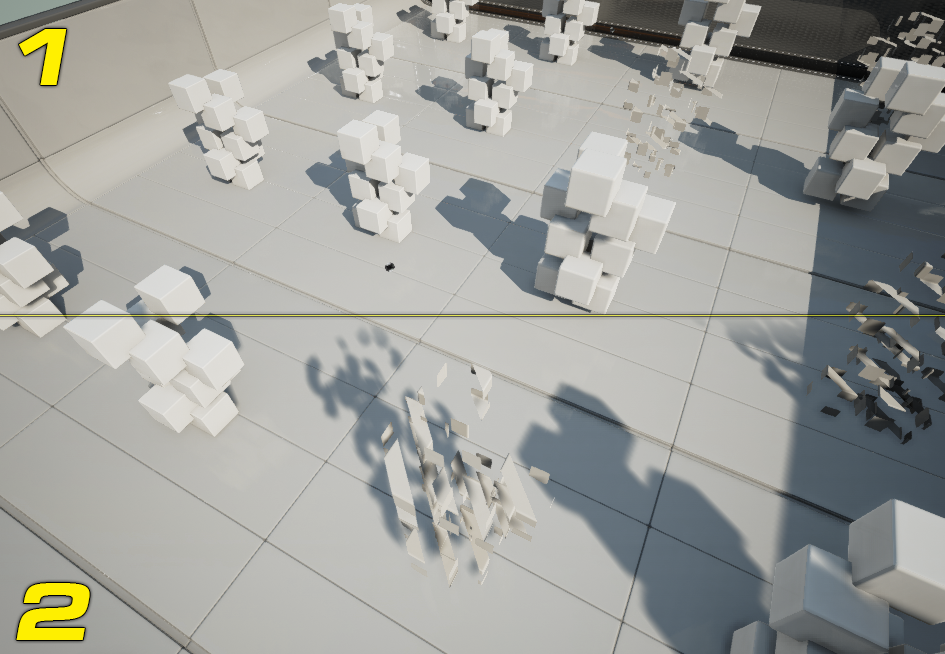
레벨에 물체 A, B가 있고 둘 다 바닥에 그림자를 드리웁니다. 땅 입장에서 A의 그림자는 받되 B의 그림자는 받고 싶지 않다면? 여기서 땅 = 캐릭터의 몸통, A = 보스, B = 캐릭터의 팔로 치환하면 정확히 우리가 풀어야 할 문제가 됩니다.
이상적인 해법과 그 한계
오브젝트마다 개별 그림자를 두고 받는 쪽에서 하나씩 결정하면 완벽합니다. 하지만 객체가 n이면 섀도우 맵도 n장, 처리 비용이 n×n으로 폭발합니다 — 비현실적입니다.
절충안 — 4개 그룹
그룹 0 — Self Shadow
원래 언리얼 엔진 동작 그대로. 모든 그림자를 받습니다.
그룹 1·2·3 — No Self
캐스팅은 하되 자기 그룹의 그림자는 받지 않습니다. 캐릭터 파츠를 한 그룹으로 묶으면 셀프 섀도우만 꺼집니다.
구현 ① 언리얼의 기존 그림자 등록 구조
예시 상황은 디렉셔널 라이트 1개, 카메라 거리에 따른 캐스케이드 3개, 레벨에 프리미티브 3개입니다.
- 그림자를 그리는 주체는
FProjectedShadowInfo이며, 디렉셔널 라이트마다 캐스케이드 수만큼 생성됩니다(여기서는 3개). - 실제로 그림자를 드리우는 프리미티브들은 Subject Primitive로서
AddSubjectPrimitive를 통해 각 ShadowInfo에 등록됩니다. - 즉 같은 캐스케이드의 ShadowInfo에 여러 프리미티브가 모이는 구조입니다.
구현 ② 그룹 개념 삽입 — 세 곳
코드에서 “Layer”가 곧 “그룹”이라고 보면 됩니다.
| # | 위치 | 내용 |
|---|---|---|
| 1 | PrimitiveComponent → SceneProxy | 컴포넌트의 그룹 값을 설정하고 SceneProxy로 옮깁니다. 렌더 스레드는 컴포넌트가 아니라 SceneProxy를 통해 프리미티브를 다루기 때문입니다. 이후 GPU Scene에도 이 프록시를 거쳐 함께 올라갑니다. |
| 2 | AddViewDependentWholeSceneShadowsForView | 이 함수가 섀도우 그룹을 넘겨받도록 수정하고, 그룹 0~3까지 매번 호출하면서 넘긴 그룹 값을 할당받은 ShadowInfo를 생성합니다 → 4 × 캐스케이드 수만큼의 ShadowInfo가 만들어집니다. (내부에서 CSM 분기와 VSM 분기로 나뉘며, VSM 쪽에서는 디렉셔널 라이트 섀도우 추가 경로가 불립니다.) |
| 3 | AddSubjectPrimitive | 프리미티브의 그룹과 ShadowInfo의 그룹이 일치할 때만 등록하도록 수정합니다. |
결과: 메시들이 그룹 0~3까지 서로 다른 레벨의 ShadowInfo로 갈라져 놓입니다.
구현 ③ Nanite는 별개다 — 비트 플래그 패킹
기초 다지기
Nanite에서는 CPU가 “무엇을 그릴지” 결정하지 않는다
Nanite는 메시를 약 128 삼각형 단위의 클러스터 트리로 임포트해두고, 매 프레임 GPU가 직접 인스턴스를 컬링하고 계층을 순회하며 LOD를 골라 래스터화합니다. 공식 문서 표현이 “Nanite runs in its own rendering pass that completely bypasses traditional draw calls”입니다.
그래서 CPU가 뷰별·오브젝트별 드로우 콜 목록을 만들지 않습니다. 그림자도 마찬가지로 한꺼번에 소비됩니다 — VSM 문서에 “All Directional Lights are rendered in a single Nanite pass, and all local lights are done in a second pass”라고 적혀 있습니다. 따라서 “이 오브젝트는 이 뷰에서만 다르게”라는 요구는 CPU 분기가 아니라 컬링 셰이더가 읽는 데이터로 밀어 넣어야 합니다. 이게 발표자가 마주한 제약이었습니다.
| 플래그 | 담는 정보 |
|---|---|
| Nanite View Flag | 남아 있는 비트를 활용해, 지금 그림자 렌더링을 진행하는 뷰에서 컬링을 할지 여부와 그룹 숫자를 기록합니다. (뷰 구조체에 플래그 비트필드가 실제로 존재합니다 — 예: NANITE_VIEW_FLAG_NEAR_CLIP) |
| GPU Scene의 Primitive Visibility Flag | 남아 있는 비트를 활용해 각 프리미티브가 어느 그룹에 속하는지를 담습니다.[5] |
인스턴스 컬링 단계에서 이 둘의 그룹 값을 즉석에서 읽고 비교하여, 서로 다르면 그 인스턴스를 걸러냅니다.
구현 ④ 실제 섀도우 맵 그리기
| 대상 | 함수 | 특징 |
|---|---|---|
| 섀도우 맵 / VSM | RenderShadowDepthMaps | 그룹별로 등급만 해주면 아틀라스 페이지 영역이 자동으로 렌더링됩니다. “등록이 곧 예약”이라 별도 추가 수정 없이 간단합니다. |
| Screen Space Shadow (섀도우 마스크) | RenderShadowProjections | 섀도우 맵이 그려진 다음, 그룹마다 별도의 렌더 타겟을 명시하고 원하는 그룹의 섀도우 맵만 프로젝션을 요청해서 그립니다. |
그룹이 나뉜 만큼 각 그룹마다 프로젝션을 한 번씩 더 수행합니다 — 이것이 이 기능의 실제 비용입니다. 그렇게 만든 그룹별 그림자 리소스는 셰이더 매크로/파라미터를 통해 베이스 패스로 전달됩니다.
구현 ⑤ 샘플링 규칙
| 그룹 | 샘플링 규칙 |
|---|---|
| 0번 (Self Shadow) | 예외 없이 모든 그룹의 그림자를 다 샘플링해서 합산 |
| 1·2·3번 (No Self) | 자기 그룹만 빼고 나머지를 곱함 |
캐릭터 파츠들을 한 그룹으로 묶어두면 캐릭터의 셀프 섀도우는 꺼지고 다른 그룹의 그림자는 정상적으로 받게 됩니다.
경로별로는 CSM이면 구워진 마스크 텍스처를, VSM이면 전용 함수로 가상 페이지 맵을 직접 읽도록 코드에서 분기합니다.[6]
나머지 일반 머티리얼은?
Deferred에서 Stylized Anime 외의 머티리얼은 그림자를 라이트 패스에서 그리고, 모든 그룹의 그림자를 다 받아야 합니다.
| 경로 | 처리 |
|---|---|
| CSM 섀도우 마스크 | 4개의 그림자 리소스에 대해 4번 샘플링 |
| VSM | 언리얼에서 VSM은 라이팅 단계 직전에 스크린 섀도우 마스크 형태로 프로젝션한 뒤 라이팅 패스로 넘깁니다. 따라서 일반 머티리얼이 모든 그림자를 받도록 VSM 프로젝션이 모든 그룹의 페이지 맵을 받을 수 있게 했습니다. |
허들 5
메인 라이트 외의 광원 — 로컬 라이트와 인다이렉트
노드로 열 수 없는 것들은 “커브 한 장”으로 통제했습니다.
| # | 전용 노드 방식이 안 되는 이유 (허들 2의 이유 재확인) |
|---|---|
| 1 | for문이 없어 개수를 모르는 로컬 라이트를 순회할 수 없습니다 |
| 2 | 라이트 타입마다 입출력이 달라 하나의 노드로 묶기 어렵습니다 |
| 3 | 인다이렉트 라이트는 아예 베이스 패스가 아닌 다른 패스에서 처리되어 머티리얼이 직접 손댈 수 없습니다 |
그래서 허들 1의 BxDF 수정 방식을 다시 가져오되, 그대로가 아니라 커브 에셋을 얹어 아티스트 친화적인 방향으로 접근합니다.
라이트 커브 — 가로축은 원래 라이팅, 세로축은 결과
선형 (기울기 1)
입력과 결과가 똑같음 — 엔진 기본 그대로
셀 커브 (계단형)
결과값이 몇 구간으로 뚝뚝 끊기면서 툰 특유의 딱 떨어지는 음영 경계가 생김
모든 값이 1 (상수)
노멀(N·L)에 의한 명암 변화는 없어지고 거리에 의한 감쇠만 남음. 발표자는 이게 카툰 렌더링에 제일 어울리는 로컬 라이트 커브라고 봤습니다
핵심 관점은 “라이트의 비율 값에만 영향을 받고, 종류나 개수를 일일이 대응하지 않는다”입니다. 메인 라이트로 툰 셰이더를 만들고, 그 외 광원은 커브로 정도만 조절합니다.
커브를 셰이더로 넘기기
1D 커브 구조를 그대로 GPU로 옮길 수도 있지만 구조가 복잡하고 계산 효율도 좋지 않습니다. 채택한 방식은 이렇습니다.
- 커브를 여러 지점에서 미리 샘플링해 StructuredBuffer로 업로드합니다.
- 셰이더는 런타임 입력 값으로 인덱스와 프랙션을 구해 주변 두 샘플을 읽고 선형 보간 한 번으로 값을 얻습니다.
- 이 샘플링은 쿡 타임이 아니라 플레이 시점에 이뤄집니다.
| 설정 | 값 |
|---|---|
| 샘플 카운트 | 프로젝트 설정에서 조절, 기본 256 |
| 낮추면 | 메모리·캐시 유리 / 정확도 하락 |
| 높이면 | 그 반대 |
로컬 라이트 적용 — 딱 두 군데 수정
Default Lit 라이팅 함수를 복제한 다음 두 곳만 고쳤습니다.
- 계산 전에 N·L을 로컬 라이트용 커브로 변환합니다.
- 계산이 끝난 Diffuse와 Specular 값에 스타일라이징 팩터를 곱합니다.
이 팩터는 라이트별이 아니라 디렉셔널을 뺀 모든 라이트를 한꺼번에 통제하는 전용 가중치이며, 디퓨즈용과 스페큘러용 두 개가 있습니다.
인다이렉트 라이트 — 무엇을 변환할 것인가
문제는 인다이렉트 연산에 N·L, 즉 라이트 방향과 노멀 사이의 각도항이 없다는 것입니다. 로컬 라이트처럼 N·L 커브에 넣을 수가 없습니다. 그래서 라이팅 결과로 나온 색의 밝기를 변환하는 쪽으로 방향을 틀었습니다 — 색조(Hue)와 채도(Saturation)는 보존하고 명도(Value)만 카툰풍으로 조절하는 방침입니다.
간접광 RGB  →  HSV로 변환 (V = 밝기 정보 취득)
            →  V를 커브로 리맵
            →  다시 RGB로 복원
결과: 색조·채도는 그대로, 밝기만 조절
기초 다지기
간접광은 0~1로 딱 떨어지지 않는다
언리얼의 라이팅은 HDR입니다. 얼마나 넓은 범위인지는 엔진이 GBuffer에 간접광 조도를 담는 방식에서 드러납니다 — 값을 그대로 넣지 않고 로그로 인코딩해서 넣고, 디코딩 범위가 대략 0.004에서 256까지입니다. 값이 1을 한참 넘길 수 있다는 걸 전제로 설계된 것입니다.
그래서 0~1 도메인만 가진 일반 커브 에셋을 그대로 쓸 수 없습니다. 발표자는 커브 샘플링 범위를 Min/Max로 직접 지정하고, 범위를 벗어난 값은 설정에 따라 익스트라폴레이션하도록 처리했습니다. 커브 에셋의 정의역과 HDR 입력의 불일치를 다루는 일반적인 패턴으로 기억해둘 만합니다.
더 깊이
HSV 왕복 비용을 줄일 수 있을까
HSV의 V는 max(R, G, B)입니다. 그래서 원본 RGB 전체에 V′/V를 곱하면 H와 S는 그대로 두고 V만 V′로 바뀝니다. 즉 이 곱셈은 근사가 아니라 HSV에서 V만 리맵한 결과와 정확히 같아서, HSV 왕복 없이 같은 값을 얻습니다. V가 0인 픽셀만 0으로 나누지 않게 따로 처리하면 됩니다.
적용 위치는 간접광 관련 엔진 셰이더입니다. 베이스 패스의 간접광 반사항이나 Diffuse Indirect Composite 같은 패스에서, 컴포짓된 간접광 색에 이 변환 함수를 한 번씩 호출하는 방식입니다. 그 결과 로컬 라이트와 인다이렉트에도 제한적이지만 아티스트에게 자유도를 줄 수 있었습니다.
허들 6
구역별로 다르게 적용하고 싶다
여기까지의 파라미터는 전부 레벨 전역입니다. 포스트 프로세스 볼륨으로 구역화합니다.
메인 라이트 쪽을 제외한 내용들 — 로컬 라이트 커브, 인다이렉트 커브, 그리고 둘 모두에 적용되는 디퓨즈·스페큘러 팩터 — 은 전부 레벨 전역으로 적용되는 파라미터입니다. 이걸 포스트 프로세스 볼륨으로 구역마다 다르게 줄 수 있다면, 한 레벨·한 캐릭터 셋업만으로 구역마다 다른 표현을 만들 수 있습니다.
| # | 위치 | 내용 |
|---|---|---|
| 1 | DetailCustomizations의 RegisterSectionMappings | 포스트 프로세스 볼륨의 Stylized Anime 섹션을 한 줄 추가해 디테일 패널의 전용 섹션을 만듭니다. (엔진에서 디테일 패널 섹션을 등록하는 표준 자리이며, FindOrCreateSection과 짝을 이룹니다.) |
| 2 | Scene.h의 FPostProcessSettings | 항목마다 오버라이드 플래그(bOverride_*)를 두고, 새 프로퍼티의 Category를 Stylized Anime으로 하면 방금 만든 섹션에 자동으로 묶입니다. 구조체 문서 설명 자체가 “각 프로퍼티는 그것을 켜는 bool(기본 off)과 변수 선언, 기본값으로 구성된다”입니다. |
| 3 | 블렌딩 | Override가 켜진 항목만 골라서 구역별로 선형 보간(lerp)합니다. 이게 엔진의 기본 동작이기도 합니다 — 보간은 “설정된(overridden) 프로퍼티만” 건드립니다. |
이 허들의 구현량이 가장 적습니다. 엔진이 이미 오버라이드 플래그 + 섹션 등록이라는 확장 지점을 갖고 있기 때문입니다.
활용 예시 — 같은 레벨, 같은 캐릭터, 완전히 다른 표현
시네마틱
- 설정
- 주변 로컬 라이트나 환경 라이팅에 영향받지 않도록
- 의도
- 캐릭터가 거의 애니처럼 보이도록 의도한 룩을 그대로 고정
게임플레이
- 설정
- 로컬 라이트와 인다이렉트 라이트를 PBR에 가깝게 받음
- 의도
- 환경과 자연스럽게 어우러지도록
뷰티파이
자체 명명
- 설정
- 로컬 라이트를 상수에 가깝게
- 의도
- 라이트를 과장되게 받아서 동화적이고 화사한 연출
허들 7
커스텀 데이터를 포스트 프로세스까지 넘기기
아티스트가 머티리얼에 정의한 값을 GBuffer에 실어 보내는 통로를 직접 설계했습니다.
| # | 효과 | 방식 |
|---|---|---|
| 1 | 2D 림 라이트 | 림을 넣고 싶은 부위를 마스크로 표시해두고, 포스트 프로세스에서 그 영역에만 림을 그림 |
| 2 | 머리카락 그림자 | 머리카락 영역을 표시해두고, 포스트 프로세스에서 경계에 그림자를 그려 얼굴에 떨어지는 그림자를 연출 |
| 3 | 후처리 그림자 착색 | 영역에 따라 그림자 색을 다르게 부여 |
기초 다지기
GBuffer에 “남는 채널”이 없다는 게 무슨 뜻인가
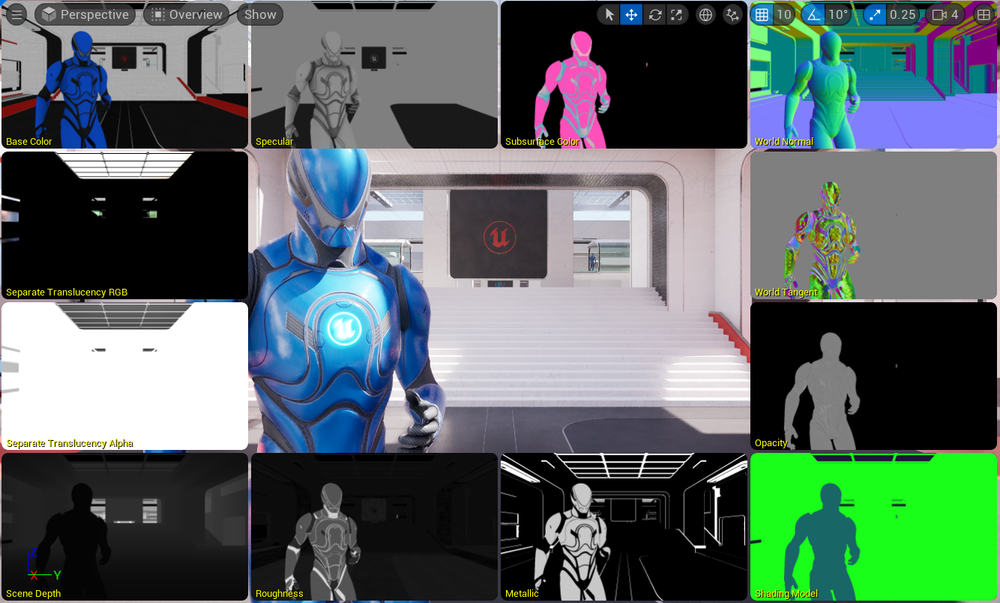
GBuffer는 디퍼드 베이스 패스가 픽셀별 머티리얼 정보를 적어두는 풀스크린 렌더 타겟 묶음입니다. 라이팅은 나중에 머티리얼 그래프를 다시 돌리는 대신 이 버퍼를 읽습니다. PC 디퍼드 기본 레이아웃은 대략 이렇습니다.
- GBufferA — RGB 월드 노멀, A 오브젝트 단위 플래그
- GBufferB — R Metallic, G Specular, B Roughness, A ShadingModelID + 출력 스킵 마스크를 8비트 한 채널에 비트 패킹(하위 4비트가 모델 ID)
- GBufferC — RGB BaseColor, A AO (스태틱 라이팅에서는 로그 인코딩된 간접광 조도)
- GBufferD — CustomData. Subsurface·ClearCoat·Hair·Cloth·Eye 등 추가 입력이 필요한 모든 셰이딩 모델이 공유합니다
- GBufferE — 프리컴퓨티드 섀도우 팩터 · GBufferF — 월드 탄젠트 + Anisotropy · Velocity는 별도 타겟
모든 채널에 주인이 있고, 일부는 비트 단위로 쪼개 쓰며, 스킵 플래그조차 4비트로 배급됩니다. 그래서 새 모델의 추가 입력은 기존 채널의 의미를 빼앗거나 GBufferD를 셰이딩 모델별로 나눠 쓰는 수밖에 없습니다. 디코딩 시점에 HasCustomGBufferData(ShadingModelID)가 “이 모델이 CustomData의 주인인가”를 판정하는 구조가 정확히 그 결과입니다.
사진 · 자료
Buffer Overview — GBuffer를 채널별로 펼쳐 본 화면
쓰는 쪽 열기 — 머티리얼 에디터
- 머티리얼 에디터의 Custom Data 핀을 사용합니다.
- 원래 이 핀은 Clear Coat나 Eye 같은 일부 셰이딩 모델에서만 열립니다. 셰이더 쪽에서도
HasCustomGBufferData가 그 모델들만 허용하고 있습니다.IsPropertyActive에 우리 셰이딩 모델을 추가해서 같이 열어뒀습니다. - 머티리얼 제작 과정에서 림 영역이나 머리카락 영역 값을 새로 열린 핀에 꽂을 수 있습니다. 각각 16비트를 할당해 충분한 표현력을 확보했습니다.
읽는 쪽 열기 — 포스트 프로세스
- 포스트 프로세스에서 쓰는 SceneTexture 노드에 항목 2개를 추가했습니다. 정의는
MaterialTemplate.ush에 있습니다. - 여기서 ID를 정의하고, 스위치 케이스 분기에서 전달받은 커스텀 데이터 값을 다시 읽어 반환하도록 했습니다.
- 결과적으로 포스트 프로세스에서 SceneTexture 노드에 ID를 설정하면 머티리얼이 써둔 커스텀 데이터 값을 그대로 쓸 수 있습니다.
핵심 — 어디에 실어 보낼 것인가 (플랫폼별)
| 경로 | 방식 | 비용 |
|---|---|---|
| PC Deferred | GBuffer 뒤에 커스텀 데이터 슬롯이 있어 그대로 사용합니다. 다만 각 채널에 할당된 비트가 8비트라, 16비트 데이터(half) 하나가 두 채널로 나뉘어 들어갑니다 — half0은 R/B에, half1은 G/A에 상위·하위로 쪼개 담고 읽을 때 다시 붙입니다. | 패킹 과정은 있지만 추가 메모리 할당 없음 → 상대적으로 가장 가벼움 |
| Forward / Mobile (Forward) | 쓸 수 있는 여유 슬롯이 없어 RG16F 포맷 렌더 타겟을 한 장 따로 생성합니다. 채널이 16비트라 쪼갤 필요 없이 그대로 담습니다. | 렌더 타겟 +1, MRT 슬롯 +1 → 메모리·대역폭 증가. Forward에서 MSAA를 쓰면 Resolve 패스가 한 번 더 들어갑니다. |
| Mobile Deferred | 불가피하게 Forward와 동일하게 새 텍스처 할당 | 아래 사유 참조 |
짚어둘 점
모바일 디퍼드는 왜 GBuffer를 못 쓰는가
공식 문서가 이유를 그대로 적어놨습니다 — “mobile deferred shading model puts GBuffer in tile memory inside the GPU, meaning that the GBuffer is never stored in system memory.” GPU 타일 메모리에만 존재하고 시스템 메모리에 남지 않으니, 나중에 도는 포스트 프로세스가 읽을 대상이 애초에 없습니다.
여유 공간도 없습니다. 같은 문서가 Mali/Android Vulkan 제약으로 픽셀당 16바이트(128비트), 입력 어태치먼트 최대 4개를 명시하고, 모바일 디퍼드는 기본적으로 이 제약을 따릅니다. 확장 GBuffer 옵션을 켜도 픽셀당 160비트로, 데스크톱보다 여전히 좁습니다. 커스텀 데이터를 위한 버퍼가 존재하지 않는다는 발표 내용과 정확히 맞물립니다.
비용 회피 장치 — 셰이딩 모델 분리
Stylized Anime
커스텀 데이터를 쓰지 않는 모델
추가 비용 없음
Stylized Anime with Custom Data
통로를 쓰는 모델
메모리와 렌더 타겟 바인딩 비용이 추가로 발생
선택을 아티스트에게 넘겨 정말 필요한 곳에만 쓰도록 했습니다. 작지만 실무적으로 매우 좋은 패턴입니다.
문서 정리 시점의 엔진 현황
그 사이 엔진 자체는 어디까지 왔나
발표 내용이 아니라, 이 문서를 정리하며 공식 자료로 확인한 맥락입니다.
아래는 세션에서 다룬 내용이 아닙니다. 발표가 “Substrate Toon이 있는데도 왜 커스터마이징인가”로 시작하기 때문에, 그 공식 기능이 실제로 무엇인지 확인해 덧붙였습니다.
UE 5.8 릴리스 노트는 Substrate Toon Shading을 Experimental로 소개합니다. Substrate Blendable GBuffer(legacy) 모드 위에 올라간 NPR 솔루션으로, 로컬 라이트·스카이 라이트·Lumen GI를 포함한 모든 라이트 타입을 지원하고, 새 Substrate Toon BSDF 노드와 Toon Profile 에셋을 통해 디퓨즈· 스페큘러 응답을 제어합니다.
- ramp 기반 디퓨즈·스페큘러 제어 + 디더링
- 해칭 패턴을 쓰는 셀프 섀도잉 익스팅션
- 비등방성 스페큘러 하이라이트
- 글로벌 일루미네이션 스케일 제어
중요한 점은 발표자의 포크 기반인 UE 5.6에는 이 기능이 없다는 것입니다. 이 세션의 “직접 다 만들었다”가 왜 필요했는지를 설명해주는 사실이고, 동시에 지금 새로 시작하는 프로젝트라면 공식 경로를 먼저 검토해야 하는 이유이기도 합니다. 반대로 이 세션이 강조한 “머티리얼 그래프에서 아티스트가 직접 만지는 자유도”는 프로파일 기반 공식 기능과 여전히 결이 다릅니다.
Q&A
레이 트레이싱으로 오브젝트 ID를 검사하는 방식과 비교하면
질문자(언리얼로 툰 렌더링을 공부 중인 대학생)는 발표를 “그룹을 나눔으로써 그룹에 따른 섀도우 맵을 만드는 장치”로 이해했다고 했습니다. 자신은 커스터마이징 당시 레이 트레이싱을 이용해 Nanite의 커스텀 셰이딩 모델 및 해당 셰이딩 모델에 부여한 셀프 ID / 오브젝트 ID를 검사하는 방식을 사용했고, 최종적으로 새로운 열을 한 개만 더 추가하도록 했다고 합니다. 어느 쪽이 나은가?
아예 방식이 조금 다른 것이라고 생각합니다. 레이 트레이싱은 툰 셰이딩 자체를 정의하는 게 조금 어렵습니다. 기본적으로 물리 라이팅을 그대로 따르고 있기 때문에, 개별 빛이 어떤 표면에 닿았을 때 어떤 식으로 표현될지를 엔진이 정의하고 있습니다. 앞서 본 것처럼 N·L에 램프 텍스처를 적용해서 자연스럽게 셰이딩된 결과가 아니라 딱딱 떨어지게끔 하려면 그런 표현이 사실 쉽지 않고, 심지어 그림자들에 대한 개별 컨트롤도 어렵습니다. 약간 다른 방식의 특징으로 봐주시면 될 것 같습니다.
샘플 프로젝트 배포 예정에 대한 질문도 있었는데, 아래 “현재 상태와 향후 계획”의 답변과 같습니다 — 공개 방식은 내부 논의 중입니다.
마무리
현재 상태와 향후 계획
이 프로젝트는 끝난 것이 아니라 지금도 내부적으로 활발하게 리서치 중이며, 어떤 기능들이 애니풍 렌더링에 제약이 되는지에 대한 리서치도 능동적으로 진행 중이라고 했습니다.
| 향후 계획 (상황에 따라 변경 가능) | 왜 어려운가 |
|---|---|
| 레이트레이싱 대응 | Q&A에서 나온 그대로 — 물리 라이팅을 전제로 하는 경로에서 계단식 음영과 그림자 개별 제어를 어떻게 정의할지가 과제 |
| 메가라이트 대응 | 라이트를 대량으로 다루는 새 경로에 커브·팩터 개념을 어떻게 얹을지 |
| Lightmass 대응 | 베이크된 라이팅과 커브 변환의 접점 |
| Substrate 머티리얼 대응 | 허들 2의 노드 검증이 “Substrate가 아닐 때”를 전제로 하고 있음 |
공개 방식은 아직 내부 논의 중입니다. 발표자는 가감 없는 피드백과 의견이 큰 힘이 된다고 전했습니다.
정리
이 세션에서 가져갈 것
진짜 주제는 카툰 렌더링이 아니라 “엔진 개조의 엔트리 포인트”다
발표자 본인이 명시했듯, 카툰 렌더링이 아니어도 엔진 튜닝에 관심이 있다면 HLSL 컴파일 순서 제어, 커스텀 머티리얼 익스프레션 등록, GBuffer 통로 설계 세 가지는 그대로 재사용 가능한 패턴입니다.
C++ 개발자의 역할은 “구현”이 아니라 “자원을 열어주는 것”이다
전용 노드 하나를 만드는 비용이 아티스트↔프로그래머 왕복 사이클을 통째로 제거합니다. 허들 1에서 허들 2로 넘어가는 동기가 이 세션 전체의 설계 철학입니다.
엔진이 막아둔 설계에는 이유가 있고, 뚫을 땐 대가를 안다
HLSL 정의 순서는 머티리얼의 엔진 내부 접근을 막은 설계로 발표자는 해석했고, GBuffer 검사 스킵은 불필요한 페이지 마킹을 감수한 것이며, 그룹 분리는 프로젝션 횟수 증가를 감수한 것입니다. 모든 해법이 트레이드오프와 함께 제시된 점이 이 발표의 미덕입니다.
Nanite는 항상 별도의 경로를 요구한다
CPU 컬링을 전제로 짠 구조는 Nanite에서 그대로 무너지고, GPU 비트 플래그 패킹이라는 완전히 다른 해법이 필요했습니다. 엔진을 손댈 때 “Nanite에서는?”을 항상 별도로 물어야 합니다.
비용이 드는 기능은 셰이딩 모델을 쪼개서 선택권을 넘긴다
허들 7의 Stylized Anime / Stylized Anime with Custom Data 분리는 작지만 실무적으로 매우 좋은 패턴입니다.
부록
각주와 참고 자료
발표에서 언급됐지만 공개 자료로 확정하지 못한 항목은 아래에 따로 모았습니다.
각주
- 셰이딩 모델 명칭 — 이 문서는 데모의 셰이딩 모델을
Stylized Anime으로 표기했습니다. 정확한 명칭은 자료 공개 시 대조가 필요합니다. UE 5.8의 공식 기능명은Substrate Toon Shading이며, 이 세션의 커스텀 모델과는 별개입니다. ↩ - Main Light 노드의 출력 핀 구성 — Direction / Color / Shadow 3개로 정리했으나, 실제 핀 이름은 자료 공개 시 확인이 필요합니다. ↩
- Deferred + CSM 경로의 “섀도우 맵 얼리 모드” — 섀도우 뎁스를 베이스 패스 앞으로 옮기는 공식 콘솔 변수는 확인되지 않았습니다. 포크의 커스텀 플래그로 보입니다. 참고로 UE4 시절 디퍼드 렌더러에서는 실제로 섀도우 뎁스가 베이스 패스보다 먼저 그려졌으므로, “원래 되던 것”에 대한 기억일 가능성도 있습니다. ↩
- Page Marking의 GBuffer 검사 — 공식 문서는 VSM 페이지 마킹을 깊이 버퍼 분석으로만 설명합니다. 셰이딩 모델·노멀 방향을 함께 보는 컬링은 이 포크에서 추가된 것일 수 있습니다. 깊이만 본다면 프리패스 뒤로 옮길 여지가 있고, “베이스 패스 산출물에 의존한다”는 결론은 GBuffer까지 검사할 때 성립합니다. ↩
- GPU Scene의 여유 비트 활용 — GPU Scene 인스턴스 데이터에 플래그 비트필드가 존재하는 것은 맞지만, 남은 비트를 커스텀 용도로 쓰는 것은 공식 확장 지점이 아닙니다. 엔진 업데이트 시 깨질 수 있는 설계입니다. ↩
- VSM 페이지 맵 직접 샘플링 함수 — 발표에서 언급된 전용 샘플링 함수 이름은 공개된 엔진 문서·코드에서 확인되지 않았습니다. 포크의 헬퍼 함수로 보이며, 공식 VSM 샘플링 패스의 이름은
VirtualShadowMapProjection입니다. ↩ - 렌더 패스 순서 — “VSM 결과가 베이스 패스 이후에 만들어진다”는 의존 관계는 공식 문서로 확인됩니다(페이지 마킹이 깊이 버퍼를 필요로 하므로). 다만 Lumen 씬 업데이트와의 정확한 상대 순서는 공식 문서에 명시되어 있지 않아, 위 도해는 발표 내용을 그대로 옮긴 것입니다. ↩
발표 중 직접 언급된 참고 자료
 Stylized Rendering Insights from Japan
 Nanite: A Deep Dive (SIGGRAPH 2021)
허들 1에서 추천 · 언리얼 페스트 2023 서울
언리얼 디퍼드 렌더를 이용한 툰 렌더링 제작기 — 유명조 (네오플)“2023년 자료지만 엔진 구조는 지금과 거의 비슷해서 훨씬 깊은 내용까지 파악 가능하다”며 추천된 강연입니다. 2023-08-30 13:10–14:00 세션. 이 제목으로 검색해야 찾을 수 있습니다.
허들 4에서 추천 · SIGGRAPH 2021
A Deep Dive into Nanite Virtualized Geometry — Brian Karis 외 (Epic Games)Persistent Culling, Hierarchical/Instance Culling 등 이 세션이 손댄 부분 외의 전체 구조. 강연 영상은 youtube.com/watch?v=eviSykqSUUw
배경 · 유니티 대비 구조 논의
Stylized Rendering Insights from Japan (Epic Games Japan)“스타일라이즈드 작업이 활발한 유니티 쪽을 많이 참고했다”는 지점과 맞물리는 강연. 같은 트랙 바로 앞 세션 발표자의 자료입니다.
이 문서의 사실 확인에 사용한 공식 자료
Epic Games 공식 문서
Virtual Shadow Maps in Unreal Engine16k×16k 가상 해상도, 128×128 페이지, 클립맵 6~22 레벨, 깊이 버퍼 기반 페이지 마킹, Nanite 단일 패스 그림자 렌더링.
Epic Games 공식 문서
Lumen Technical Details · Using the Mobile Deferred Shading ModeLumen 카드 캡처가 머티리얼 속성을 캡처한다는 서술, 모바일 디퍼드의 타일 메모리 GBuffer와 128비트·입력 어태치먼트 4개 제약.
Epic Games 릴리스 노트
Unreal Engine 5.8 Release Notes — Substrate NPR Shading (Experimental)Substrate Toon Shading, Substrate Toon BSDF 노드, Toon Profile 에셋, ramp 기반 디퓨즈·스페큘러 제어.
Epic Games 지식 베이스
How the Unreal Engine Translates a Material Graph to HLSLMaterialTemplate.ush의 자리표시자 구조와 “그래프의 대부분이 CalcPixelMaterialInputs로 들어간다”는 설명.